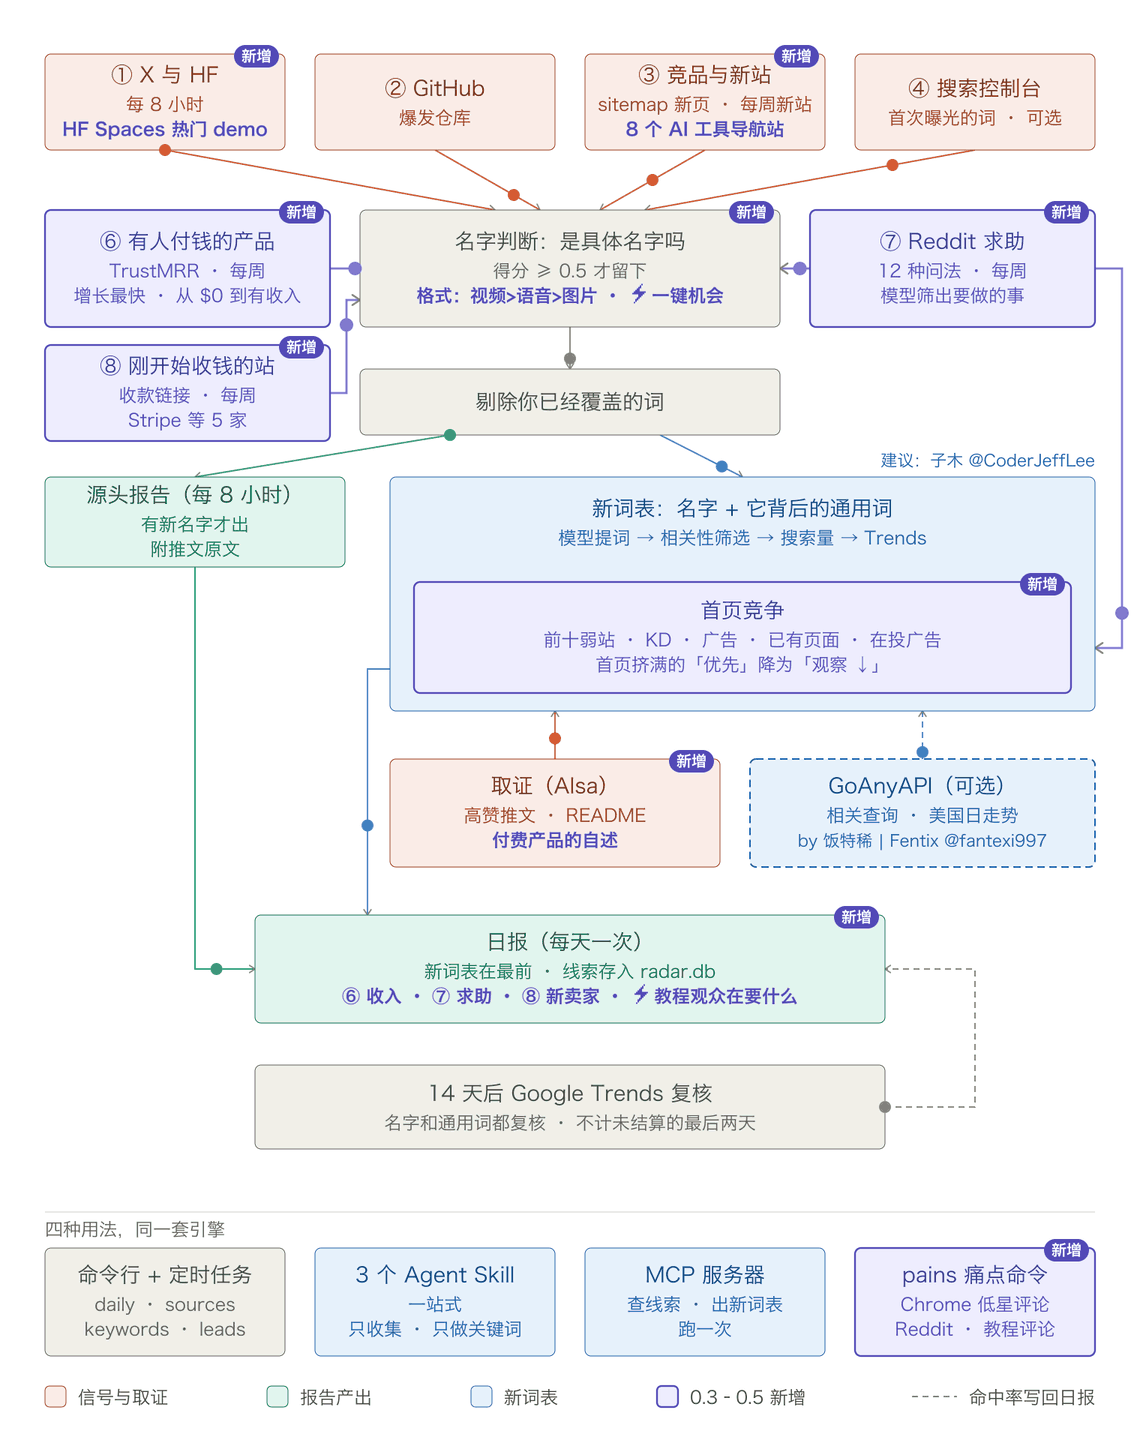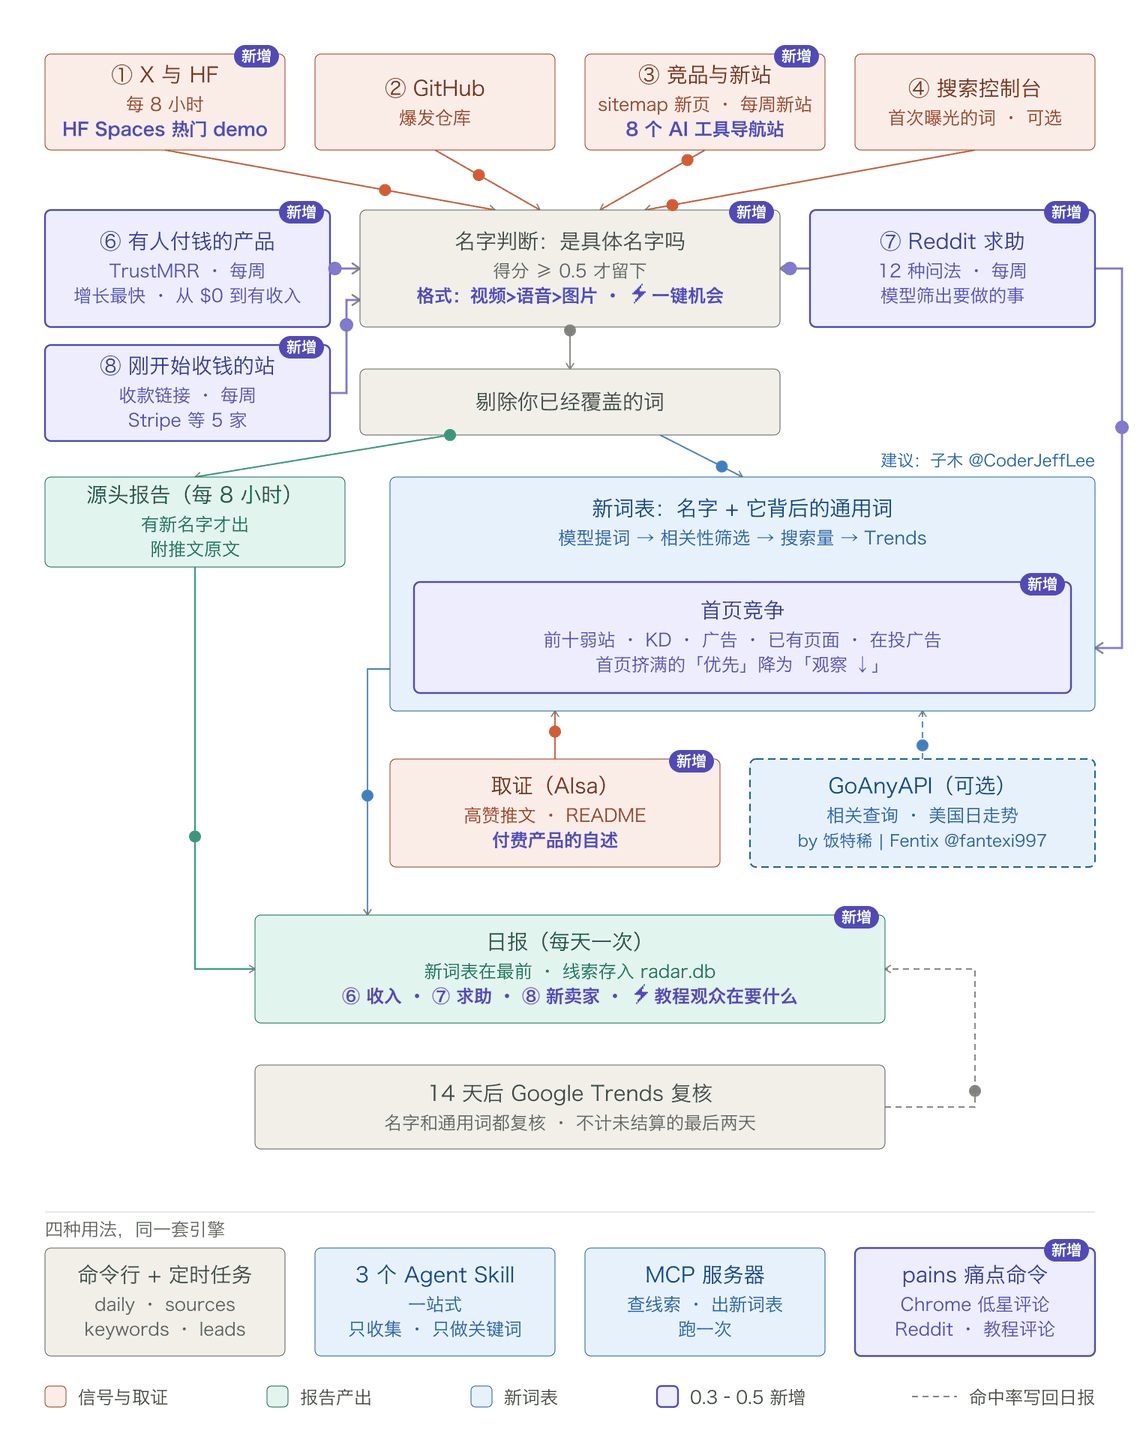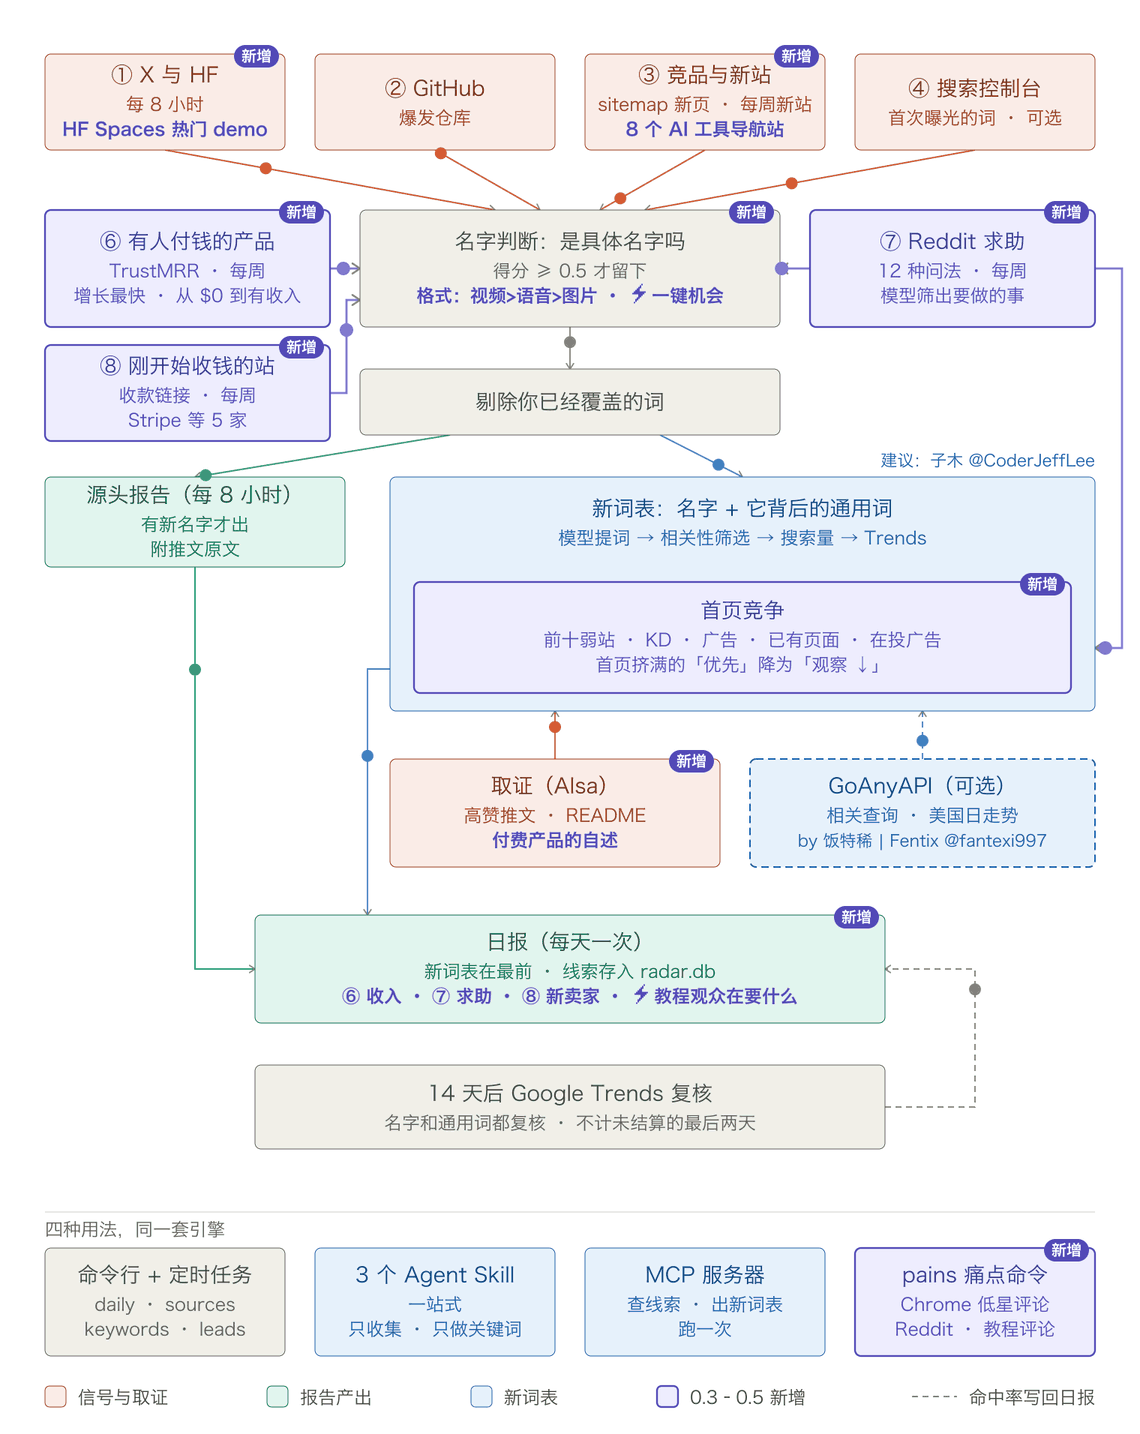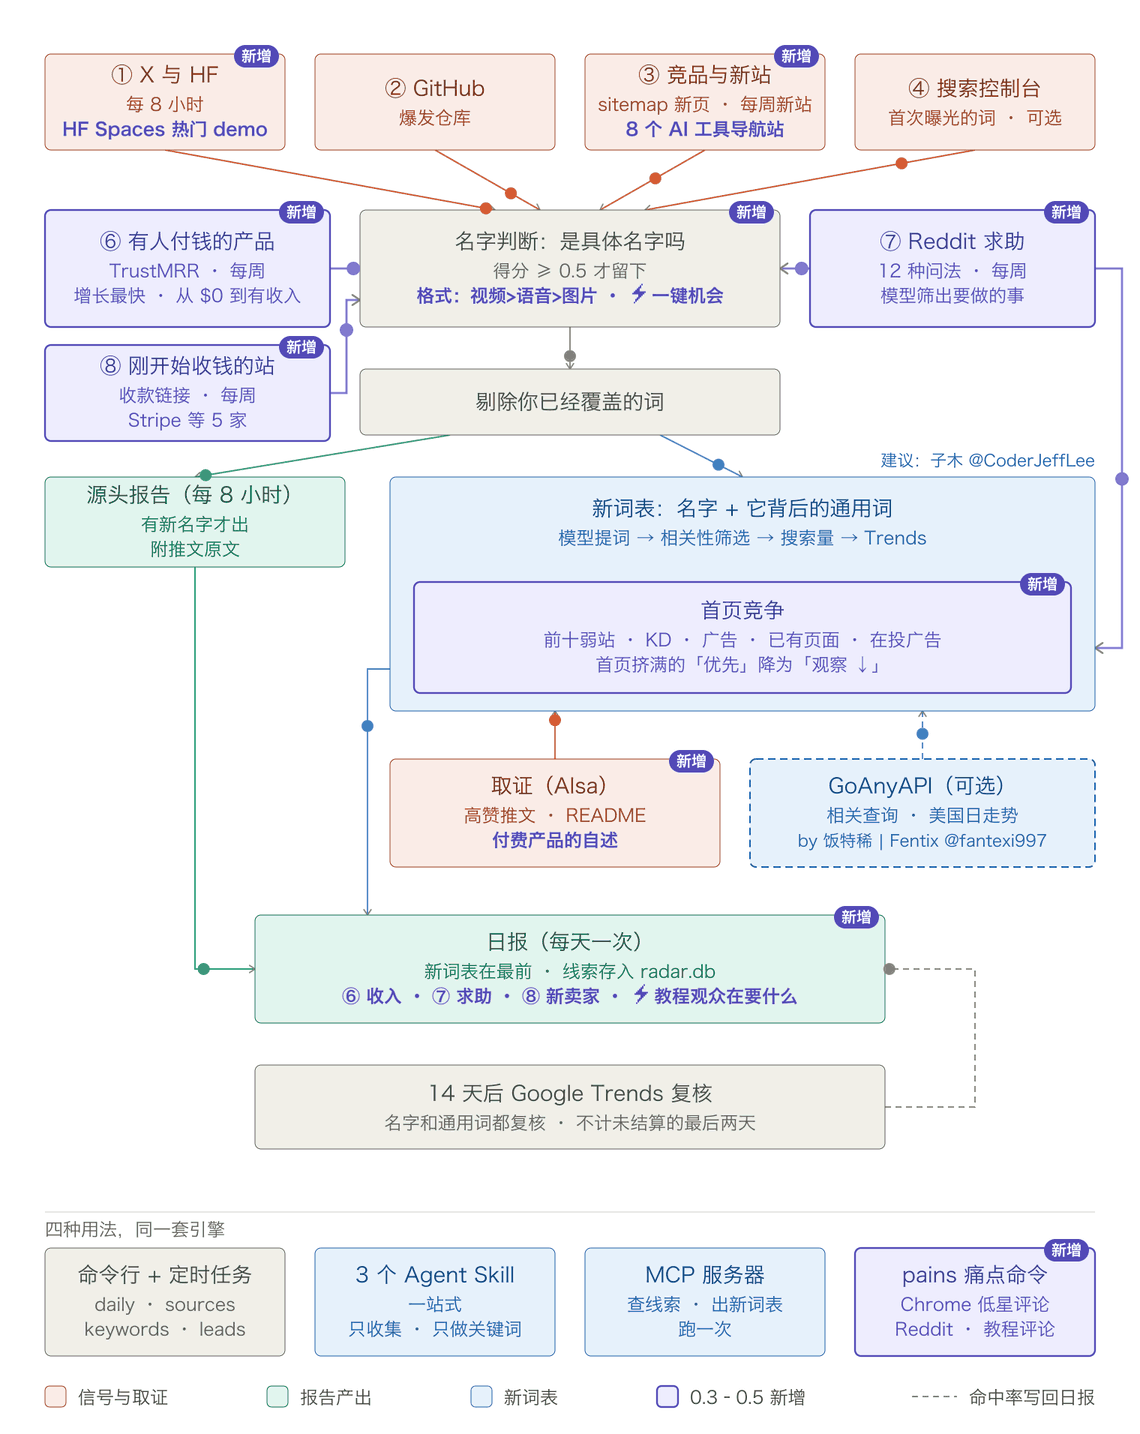
每天一份报告,列出 AI 领域里刚开始冒头的名字:新模型、新产品、新工具、新仓库。在它们最早被说出来的地方抓,而不是等关键词工具里有数据再看。
适合围绕新词做页面、写内容、做产品的人:AI 工具站的 SEO、Newsletter、导航站,或者任何想在「Strata」「Seedance」出现当天就知道、而不是两周后才知道的人。
一个新名字会按这个顺序留下痕迹:
关键词工具读的是第 5 步。这个雷达每天读第 1 到 4 步,第 5 步只用来复盘自己准不准。
它最初就是照着一个例子做的:Niko1221/Strata 创建于 2026-09-24,九天后 7,700 星。9 月 26 日起就有人在搜「niko strata」,而当时没有第二个仓库用这个名字,关键词工具里也查不到。一个仓库每天涨 800 星,这本身就是全部信号,而且是公开的。
紫色、标「新增」的是 0.3 到 0.5 加的:⑥ 收入、⑦ Reddit 求助、⑧ 新卖家、首页竞争、格式和 ⚡ 标记、pains 痛点命令。
| 信号 | 抓什么 | 需要 | 花费 |
|---|---|---|---|
| ① X | 你关注的账号里,60 天内第一次出现的名字 | AIsa key | 每个账号每次 $0.003 |
| ① Hugging Face | 新进热门榜前 50 的模型和 Space(大家实际在试的 demo);量化版、微调版和模型自己的 demo 归到同一个基础名下 | 无 | 免费 |
| ② GitHub 爆发 | 创建不到 14 天、平均每天涨 200 星以上,或比昨天多 400 星的仓库;附带大家实际会搜的写法(「niko strata」) | 无(有 GitHub token 限额更高) | 免费 |
| ③ 竞品 sitemap | 某个站新增的几个网址共用、而它的旧网址里很少出现的词。示例配置盯着 8 个 AI 工具导航站(toolify、aixploria、ai-bot.cn、opentools、dang.ai、clipfly、aitoptools、futurepedia)和 4 个 MCP、skill 目录 | 你列出的 sitemap | 免费 |
| ③ 新站 | 近 90 天注册且首次被收录、已经有 20 个以上排名词的域名 | AIsa key | 每个查询约 $0.13,每周一次 |
| ⑦ 求助 | Reddit 上大家在要什么("is there an AI tool that…" 等 12 种问法):模型留下 AI 工具能解决的求助和抱怨,把每件事写成大家会搜的说法;有搜索量的再做首页竞争检查 | AIsa key | 每周约 $0.12 |
| ⑧ 新卖家 | 刚挂上收款链接的站(Stripe Payment Links、Polar、Lemon Squeezy、Gumroad、Creem),来自公开外链数据,带每条链接首次出现的日期;平台上的用户页和论坛帖不算;站点自己的介绍交给新词表 | AIsa key;GoAnyAPI 可选,用来看访问量 | 每周约 $0.25 |
| ⑥ 收入 | 有人付钱的产品,来自 TrustMRR 核验过的收入:增长最快的(30 天收入 $500 以上)和最新上榜的;上次 $0、这次过了门槛的排最前。它自己的介绍会作为依据交给新词表 | TrustMRR key | 免费,6 次请求,每周一次 |
| ④ Search Console | 你的站第一次获得曝光的查询词(用新鲜数据) | 你自己的 Google 授权 | 免费 |
| ⑤ 复盘 | 每条线索 14 天后去 Google Trends 核对,和它自己的基线比;按信号统计命中率和提前天数 | AIsa key | 每个搜索写法 $0.0012 |
| 新词表 | 针对当天的新名字:找出它背后的通用搜索词(大家拿这个新东西做什么),逐个估算规模、看首页还有没有位置,并给出决策 | AIsa key;GoAnyAPI key 可选 | 5 个名字约每天 $0.18,加上 GoAnyAPI 约 $0.30 |
| 名字判断 | 小模型给每个词打分:是某个具体东西的名字,还是普通词? | AIsa key | 每次不到一美分 |
价格是 2026 年 10 月 AIsa 的实际收费。按示例配置(35 个 X 账号、每天读三次,新词表每天读 5 个名字),一个月约 $15:读 X 约 $10,新词表约 $5。少读几个账号或者每天只读一次,费用按比例下降。
只有名字是不够的。「SynthID Detector」作为关键词寿命短,而且是 Google 的;它做的那件事「ai image detector」才是大家会一直搜的词,而且不属于任何人。雷达每天会把新名字再读一遍,把两种词写进同一张表:
| 关键词 | 类型 | 来自 | 新词? | 估算日搜 | 开始上涨 | 峰值 vs gpts | 峰值日 | 近 7 天比前 7 天 | 现在 | 首页竞争 | 决策 |
| **photocraft** 🖼 | 名字 | — | 是 | 12747 | 2026-10-05 | 97 vs 3.1 | 2026-10-09 | — | 还在涨 | — | **优先** |
| **claude haiku 5.5** | 名字 | — | 是 | 1863 | 2026-10-07 | 100 vs 23.7 | 2026-10-08 | ×6.0 | 还在涨 | — | **优先** |
| **ai image detector** 🖼 | 通用词 | synthid detector | 否 | 2537 | — | 87 vs 31.6 | 2026-10-04 | ×1.2 | 没动 | — | 观察 |
| **photoshop alternative** ⚠ | 通用词 | photocraft | 否 | 244 | — | 61 vs 61.7 | 2026-10-08 | ×1.8 | 没动 | — | 跳过 |
(2026-10-12 一次真实运行的节选;「首页竞争」一列是后来加的,见下)
它是怎么做出来的(radar/usecases.py):
min_volume 的丢掉,大部分都会被丢掉。gpts)放在一起查,得到规模。能进 = 前十里有 3 个以上评分低于 30 的站,或难度低于 20;挤满 = 一个弱站都没有、难度 40 以上;其余为 一般。表下面会列出首页最弱的那个站(新页面最容易挤进去的位置),以及首页由哪类页面构成(工具、榜单、文章、视频、论坛)。首页有广告,说明有人在花钱买这个点击。日搜是估算值。通用词用它自己的 Google Ads 月搜索量,沿它自己的 Trends 曲线推到今天。再用这些词反推出基准词的规模,名字还没有搜索量数据,就对比基准词来估。
决策:优先 = 近 30 天涨过、现在还在高位、估算日搜不低于 min_daily。观察 = 涨了但规模小,或还太早读不出,或没动但本身有这个规模的稳定需求。跳过 = 已回落,或没动且规模小。
首页 挤满 的 优先 会降成 观察 ↓:还在涨,但首页被强站占满。新名字第一周的首页还在成形(新闻、官方页),以三天后第二次读到的为准。
标记:🎬 视频、🎙 语音、🖼 图片 说明它产出什么,一般用户愿意付费的顺序是 视频 > 语音 > 图片 > 文字;同等条件的线索按这个排序。⚡ = 有 1,000 赞以上的帖子在手把手讲一套手动流程,或在跟一个热梗:还没人做成一键工具。两者都是按关键词规则从线索自己的字句和帖子里读出来的;在 6 个已知名字上(Nano Banana、Veo 3.1、Seedance 2.5、Claude Opus 5.5、ElevenLabs v4、Qwen Image 2.1)格式 6 个全对,⚡ 只触发一次,是一条被大量转发的 Opus 5.5 + Blender + Unreal 教程。按标记行动前先读原帖。
每个名字读两次:出现当天一次,三天后一次。因为发布当天的帖子都是公告,还看不出用法。通用词也会记进线索库,14 天后和名字一起复盘。
从我们最早跑的 8 个名字看,对它应该有这样的预期:
还在涨 (US)。表照常产出,但会变薄,并且会写明缺了哪一块:
| 情况 | 表里少了什么 | 表下面会出现的一行 |
|---|---|---|
没配 GOANYAPI_API_KEY(默认就是这样) |
没有 🔎 行、没有名字的长尾、没有「一起被搜的其他名字」、没有 (US) 走势。通用词只来自模型,走势全部读全球数据,真实的上涨可能被读成「没动」 |
「相关查询未开启:设置 GOANYAPI_API_KEY 后…」 |
| GoAnyAPI 的 Trends 挂了(接入第一天 2026-10-12 就遇到过) | 这一次运行等同于没配 key | 「相关查询失败:…」和「国家数据获取失败,已退回全球数据:…」 |
| 某个名字的 AIsa 推文搜索失败(2026-10-13 遇到两次超时) | 这个名字的推文证据。仓库还有 README 可用;没有 README 的模型或产品就只剩相关查询,如果又没配 GoAnyAPI,这一天它就没有通用词 | 「推文搜索失败,这次只用了 README 和相关查询:…」 |
| 某个名字既没有推文也没有 README | 它的通用词;名字自己那一行还在 | 「没找到帖子或 README:…」 |
| 当天没有名字得分 0.8 以上的「东西」类线索 | 整张表 | 「今天没有要读的名字…」 |
| AIsa 的搜索量或 Trends 查询失败 | 整张表:这两项没有替代来源 | 表的位置直接显示报错 |
表变薄不等于今天没动静。下结论说「什么都没涨」之前,先看表下面这几行。
把配置写成 "usecases": {"per_day": 0},或者加 --skip usecases,可以关掉它。
一个能赚钱的产品,证明了它背后的需求。设置 TRUSTMRR_API_KEY(在 TrustMRR 的开发者后台生成)后,雷达每周读一次(revenue.weekday,默认周一):近 30 天收入至少 min_revenue_usd($500)、增长最快的 30 个产品,以及最新上榜的 30 个,并记下这次看到的。最新上榜的大多还几乎没收入,读它们是为了记下起点:上次 $0、这次过了门槛的产品会排在最前。隐藏的条目("Anonymous startup")不算;公司全称会换成网站名("Talent Tech Global Limited" 读作 gptproto)。每个产品自己的介绍会作为依据交给新词表,于是新词表读出的是大家付钱买的那件事,而不只是品牌名。增长超过 1,000% 的显示为「从接近 $0 涨起来」:第一次运行时,增长最快的大多是从几乎为零起步的。
TrustMRR 的 API 条款禁止转载它的数据,也禁止拿它做公开的 SEO 页面。这些线索只供你自己研究,不要公开这份清单。
雷达每周在 Reddit 上按十来种求工具的问法搜一次("is there an AI tool"、"I wish there was a tool"、"how do I automate" 等,见 asks.patterns),留下最近一周、得分 2 以上的帖子,让一个小模型分类:求助、抱怨、分享的解法,或其他。对 AI 工具能解决的求助和抱怨,它把要做的事写成大家会搜的说法("add b roll automatically"、"convert slides to notes")。月搜索量 50 以上的列出来,附上帖子并做首页竞争检查,每件事记为一条线索。大多数求助太具体,还没有搜索量:第一次真实运行,一周 84 个帖子里有 43 个求助,只有两个月搜索量过 50("best ai tool for research",来自 r/PhD 一个 1,034 分的帖子;以及 "best ai tool for coding")。所以其余得分最高的也会单独列出来,作为点子而不是关键词。试跑时读一个月的帖子,找到了「有没有 AI 工具能把 PPT 课件转成笔记」——正是一门工具站课程拿来做示范的那个需求。
帖子只供自己研究:可以引用,不要转载。
一个产品挂出第一条收款链接,比发布帖更说明问题:有人做了东西,并开口要钱。whoismaking.money 曾经按「往 Stripe 结账页送了多少流量」给网站排名(点击流数据;互联网档案馆里它最后一个真实页面是 2025 年 9 月的,到 2026 年 3 月域名已是带隐藏跳转的停放页)。同类数据通过 AIsa 的 Similarweb 买得到,但每 20 行约 $6,覆盖不了长尾。收款链接是便宜的替代:它们是卖家自己页面上的普通链接,公开外链数据里查得到,还带每条首次出现的日期。Stripe 有 14.3 万个站链着它,Polar 1,900 个(每条都是收款链接);Lemon Squeezy、Gumroad、Creem 只算店铺结账页、/l/ 商品页和 /payment/ 页,因为它们其余的链接指向自己的官网,Gumroad 还有大量被垃圾外链网络利用的个人主页。
雷达每周读每个平台最新的 100 个链接来源站(每个平台约 $0.03),只留没见过的,列出它们的访问量(GoAnyAPI)和首页自己的标题、介绍,介绍同时交给新词表当依据。第一次真实运行,排在最前面的是 janitorai.com、framer.com、pub.dev、Flathub 和一个 n8n 论坛帖:都是大平台上的用户页,链着别人的收款链接。所以现在要求链接所在的页面是这个站自己的首页、价格页或产品页,不能是帖子、话题或列表页;站点在 DataForSEO 0 到 1,000 的评分里不超过 350;月访问超过 30 万的算平台。然后由一个小模型根据各站自己的介绍按类型分好(调用失败时用关键词规则),AI 和软件排最前,然后是模板、课程和其他;同一类里访问量大的在前。第一次按类型排序,列出的 12 个全是软件(其中有 Mac 实时字幕、和 PDF 对话的工具、macOS 上的 AI 写作 app、一个 MCP 目录、一个日本的内控审计 SaaS),而只按访问量排时,排在前面的是 Blender 插件站、食谱博客和设计图库。有收款链接只说明它在卖,不说明卖得好;付款时才由代码生成的结账页看不到。
对每天最多 3 条带 ⚡ 的线索(一条被大量转发的手动流程教程),雷达找出它的热门教程视频(GoAnyAPI),读视频下的评论(AIsa,每页 $0.001),让模型挑出观众在要什么:哪一步太难、「能不能一键搞定」。这张清单就是那个一键工具。找视频需要 GoAnyAPI key。
python -m radar pains "ai headshot"把大家对一类工具的抱怨,归纳成新工具能填的缺口:
--extension ID 指定的扩展(GoAnyAPI:找扩展 2 credits,每页评论 3 credits);模型把它们归成缺口(缺功能、太难、质量、价格、想要工具),每个缺口给出次数、例子和有这个问题的人会搜的说法。每个词约 $0.05。次数是读到的条目数,不代表市场规模。
读不到的:App Store、Google Play、Trustpilot 的评论(DataForSEO 是「先提交、后取结果」的任务接口,AIsa 只支持同步调用);There's An AI For That 的求助板(每个页面前都有 Cloudflare 挑战,硬闯就是绕过对方的反爬,雷达不做);Facebook 小组(Meta 2024 年 4 月关闭了 Groups API,它的研究数据库只对获批的学术和非营利研究者开放)。
所有付费的部分都走 AIsa:X 帖子、Google Trends 和域名数据(背后是 DataForSEO)、判断名字的模型。一个 key,按次付费,不用分别订阅 X API 和 DataForSEO。
上面是推荐链接:通过它注册是对这个项目的支持。从 aisa.one 任何入口拿到的 key 用起来完全一样。
可选:GOANYAPI_API_KEY(goanyapi.com)从两方面改进新词表,每天约 $0.07:给每个名字加上 Google Trends 的相关查询;名字和规模较大的通用词(月搜 1,000 以上,最多 8 行)的走势,改用单个国家的 30 天日数据来读,这份数据结算到昨天。这些行的「现在」一列后面会标出国家,例如 还在涨 (US)。不配这个 key,新词表只用模型提出的写法和全球数据。这个服务很新(2026 年 8 月才发布);我们测试时每次调用要 20 到 55 秒,大约十次有一次失败,所以雷达会试两次,失败就写在表里,继续往下跑。上面这个也是推荐链接。
没有 AIsa 的 key 时,免费的信号照常运行(Hugging Face、GitHub、sitemap、Search Console),只是报告里所有词不分先后列出,因为没有模型判断哪些是名字。
需要 Python 3.10 或更高版本。雷达本身只用标准库。
git clone https://github.com/zhuyansen/new-term-radar
cd new-term-radar
cp config.example.json config.json      # 然后编辑:你的 X 账号、sitemap、主题;想要中文报告把 lang 改成 "zh"
export AISA_API_KEY=...                 # 从 https://go.aisa.one/yansen-zhu 获取;用 AIsa 命令行 `aisa login` 登录过也可以
python -m radar daily --out report.md
第一次运行只是建立快照:昨天的 X 词表、星数、sitemap 网址都还没有,所以只会报出 GitHub 爆发仓库(它不依赖昨天的数据)。从第二次运行起,每个信号都会报告变化。
两个命令:
python -m radar sources --out sources.md           # 只跑 ①:X 和 Hugging Face,每隔几小时跑一次
python -m radar daily --skip x,hf --out report.md  # 其余全部,每天一次
sources 只在有新名字时才写报告。daily 带 --skip x,hf 时,会列出 sources 在过去 24 小时记下的线索。如果你每天只跑一次,直接用 python -m radar daily,什么都不跳过。
其他参数:--skip 可选 x,hf,breakout,sitemaps,newsites,gsc,review,judge,usecases;--new-sites 让每周信号今天就跑;--mail 发邮件(见下);--state DIR 指定数据库和快照的目录。
2026-10-12 一次真实运行的节选(中文报告,"lang": "zh"):
### 候选新词(判为专有名词的排前面;已覆盖的会标出)

| 词 | 信号 | 名字得分 | 已覆盖 | 搜索变体 | 例子 |
| **gridcraft** | GitHub 爆发 storytold/gridcraft ★3178(均 626/天) | 0.95 | 无 | storytold gridcraft | GridCraft: an open-source, cl… |
| **artex** | GitHub 爆发 mhtsec/ARTEX ★3353(均 825/天) | 0.85 | 无 | mhtsec artex, mht artex | AI 自主渗透测试系统 … |

其他上升词(判为普通词):anatomy, math, iphone use

### ⑤ 复盘(14 天前报出的词,在 Google Trends 里起没起来)

| 词 | 首次报出 | 结论 | 提前天数 |
| strata | 2026-09-25 | hit | 3 |
daily 还会在 Markdown 旁边写一份 report.json,包含生成报告用到的全部数据。
| 字段 | 含义 |
|---|---|
lang |
"en" 或 "zh":报告的语言 |
x_accounts |
labs 和 bloggers:要读的 X 账号。实验室最先说出名字;博主选你这个领域里新词靠谁传开 |
sitemaps |
想看哪些站新增了什么页面。index 是一个 sitemap;如果它是 sitemap 索引,用 shards(正则)挑要读的子 sitemap。pause 是对这个站两次请求之间的秒数。strip_locale 去掉 /en/、/zh-CN/ 这类前缀,同一条目的多语言版本只算一次 |
topics |
名称和正则:每个主题单独一节,列出匹配的线索、仓库和查询 |
known_terms |
你已经有页面的词,或者永远不想看到的词。包含它或被它包含的线索会被标出,不进入复盘 |
stop_words |
你这个领域的日常用词,追加到内置列表(内置列表是按 AI 工具领域调的) |
judge |
model(AIsa 上任意对话模型)和 min_score(默认 0.5) |
breakout |
window_days、min_stars、velocity_min(每天涨星)、delta_min(比昨天多的星) |
new_sites |
queries:名称和域名的 SQL LIKE 模式("%ai%"),每个是一次付费查询;weekday(0 = 周一) |
review |
after_days(14)和 per_day(每天复盘 5 条) |
usecases |
新词表。per_day(每天读几个名字,0 = 关闭)、model、benchmark(用来比规模的基准词)、min_volume(写法至少要有的月搜索量)、min_daily(判为「优先」所需的日搜)、recheck_days(3)、related(设了 GOANYAPI_API_KEY 时是否用相关查询)、related_geo(US)、country_trends(规模较大的行改读该国数据)、country_min_volume(1000)、country_max(8) |
gsc |
site(sc-domain:example.com)和 token_file。留 {} 即关闭 |
添加某个站的 sitemap 之前,请先看它的 robots.txt,pause 不要低于它的 crawl-delay。示例配置每天总共几十次请求,按 pause 间隔发出。
pip install google-auth-oauthlib
python scripts/gsc_auth.py gsc_client.json   # 打开一次浏览器授权,写出 gsc_token.json
gsc_client.json 是 Google Cloud Console 里类型为「桌面应用」的 OAuth 客户端,所在项目要启用 Search Console API。然后设置 "gsc": {"site": "sc-domain:你的域名"}。授权是只读的,凭证只留在你自己的机器上,.gitignore 已经把它排除了。
--mail 通过 Resend 发送报告。设置 RESEND_API_KEY、EMAIL_FROM(你在 Resend 验证过的域名下的地址)和 RADAR_EMAIL_TO(多个用逗号分隔)。要 HTML 版需要 pip install markdown。
skills/ 里有三个 Agent Skill:一个把整件事做完,另外两个是拆开的两半,给想分开用的人。
| Skill | 做什么 |
|---|---|
new-term-radar |
一次跑完:今天的新名字,加上它们的关键词优先级表。也可以直接给它你已有的名字。从这个开始 |
ai-listening |
把各路信号最近 24 小时的新东西收集起来、去重,出一份名字报告 |
seo-new-keywords-research |
给它名字,或者一段提到这些名字的原始文本,它返回关键词优先级表:每个名字背后的通用词,经过筛选、估算规模并给出决策 |
npx skills add zhuyansen/new-term-radar
在 Claude Code 里,这三个 skill 也可以作为插件安装:
/plugin marketplace add zhuyansen/new-term-radar
/plugin install new-term-radar@new-term-radar
然后对你的 agent 说「今天有哪些 AI 新词」「出一份 AI listening 报告」或「给 PhotoCraft 和 SynthID Detector 做关键词调研」。skill 会在本机没有这个仓库时把它克隆到 ~/new-term-radar,在任何付费运行之前先告诉你大概花多少,表不完整时也会说明。
给支持 MCP 的客户端用(Claude Code、Cursor、Claude Desktop):
pip install "new-term-radar[mcp] @ git+https://github.com/zhuyansen/new-term-radar"
{
  "mcpServers": {
    "new-term-radar": {
      "command": "new-term-radar-mcp",
      "env": {
        "AISA_API_KEY": "...",
        "RADAR_CONFIG": "/绝对路径/config.json",
        "RADAR_STATE": "/绝对路径/state"
      }
    }
  }
}
| 工具 | 返回什么 | 花费和耗时 |
|---|---|---|
recent_leads |
雷达记下的线索,带复盘结论和各信号命中率 | 免费,立刻返回 |
keyword_table |
你给的名字的新词表 | 每个名字约 $0.05,每次调用另加 $0.09;每个名字 40 到 90 秒 |
run_radar |
跑一次 sources 或 daily,返回报告 |
付费,要几分钟。只适合第一次试用,定时运行应该交给 cron 或 Actions |
把 RADAR_STATE 指向定时任务写入的那个目录,recent_leads 看到的就是定时任务记下的线索。同样的两个功能在命令行里也有:python -m radar keywords "名字" … 和 python -m radar leads。
.github/workflows/radar.yml 每 8 小时跑一次 sources、每天跑一次 daily,状态存在 Actions 缓存里,报告写到每次运行的摘要页。默认关闭,需要你主动开启:
config.json 从 .gitignore 里删掉,提交你的配置。配置里没有任何密钥。AISA_API_KEY;可选 GOANYAPI_API_KEY、RESEND_API_KEY、EMAIL_FROM、RADAR_EMAIL_TO、GSC_TOKEN_JSON。RADAR_ENABLED 设为 true。radar/terms.py):首字母大写的词、带数字的词(Qwen3.8)、中间有大写的词(HyperFrames);名字后面的数字会并进去(Opus 5.5)。两个账号都用过的名字算数;只有一个账号用的,需要 100 个赞,而且必须明显是名字,因为首字母大写的词常常只是句子开头。radar/judge.py):每 25 个词一次模型调用,每个词附带最多三处出现的原文。调用失败时报告照常发出,只是不排序。radar/review.py):一个搜索写法在我们报出之后的峰值,超过它自己之前基线的 2 倍且高出 10 点,才算「涨了」。有旧含义的词(「strata」:岩层、分契式产权)基线本来就高,不算;「niko1221 strata」从 0 涨起来才算。Trends 没结算的最后两天不计入。gpt-4.1-mini):拿我们自己日常使用中、之前的判断器放行的 170 个词重新判了一遍,它同意其中 149 个。它拒掉的 21 个里,大部分是之前误放的噪音(sitemap 路径碎片如 io.github.wxt invoice、asd),真正漏掉的名字大约 3 个(synthid detector、veo、v4.1 flash),而且这次测试给它的上下文比实际运行时少。40 个普通词(dashboard、pricing、today)没有一个被放行。post_dataforseo_domains_whois_overview_live 的参数校验目前会拒绝 DataForSEO 要求的筛选格式,所以这个信号会报错,报告的其余部分不受影响。2026-10-06 之前是正常的。上游修复之前可以用 --skip newsites 关掉。stop_words。pip install pytest markdown
python -m pytest -q tests
测试覆盖逻辑部分(名字提取、打分、存储、报告),不访问网络。
流程图由 docs/make_diagram.py 生成(需要 rsvg-convert 和 ffmpeg)。
MIT。这套雷达提取自 agentskillshub.top 背后每天在跑的版本。